ユースケース
LLM と avacast で作る、英会話の練習相手
音声認識で聞き取り、LLM が返事を考え、avacast が話す。3 つの部品を組み合わせて、ブラウザで英語の会話練習ができる画面を作ります。
全体の構成
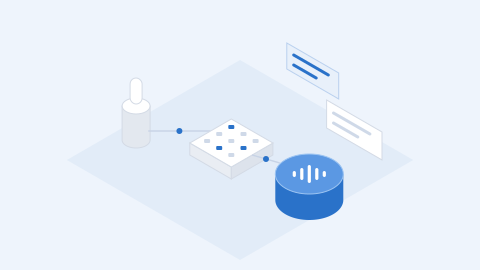
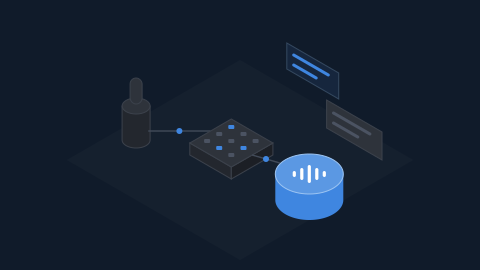
利用者の声はブラウザの音声認識で文字にし、サーバーに送ります。サーバーは LLM に返事を作らせ、その文章を avacast の speak に渡します。映像と音声は WebRTC でブラウザに届きます。
- ブラウザ: 音声認識 (Web Speech API) と、avacast の SDK での映像の表示
- サーバー: 会話の履歴を持って LLM を呼び、返事を avacast へ渡す
- avacast: 渡された英文を音声と口の動きにして、映像として配信する
avacast に含まれるのは、渡された文章を話す部分です。返事を考える LLM と音声認識は、使い慣れたものを組み合わせます。
英語の声でセッションを作る
セッションはサーバーで API キーを使って作ります。voice.language を en にすると英語で話します。voice.speed は 0.8〜1.2 で、学習者向けに少しゆっくりにしておくと聞き取りやすくなります。
サーバー (セッションの作成)
const res = await fetch('https://api.avacast.jp/v1/sessions', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.AVACAST_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
    avatar_id: 'avt_xxxxxxxx',
    voice: { language: 'en', speed: 0.9 },
  }),
});
const { session_id, client_token, webrtc } = await res.json();
// ブラウザへは session_id・client_token・webrtc を返す (API キーは返さない)
ブラウザでは、受け取った値を SDK に渡して映像を表示します。
ブラウザ (映像の表示)
import { AvacastSession } from 'avacast';

const session = new AvacastSession(client_token, {
  signalingUrl: webrtc.signaling_url,
  iceServers: webrtc.ice_servers,
});
session.attach(document.getElementById('avatar'));
await session.start();
ブラウザで英語を聞き取る
音声認識はブラウザの SpeechRecognition を使います。lang を en-US にして、聞き取った英文をサーバーへ送ります。利用者が話し始めたら session.interrupt() を呼ぶと、アバターが話している途中の返事を止められます。
ブラウザ (音声認識)
const Recognition = window.SpeechRecognition || window.webkitSpeechRecognition;
const rec = new Recognition();
rec.lang = 'en-US';

rec.onspeechstart = () => session.interrupt();
rec.onresult = async (e) => {
  const userText = e.results[0][0].transcript;
  await fetch('/api/reply', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ sessionId: session_id, userText }),
  });
};

talkButton.addEventListener('click', () => rec.start());
SpeechRecognition が使えないブラウザでは、録音した音声をサーバー側の音声認識サービスに送る形に置き換えます。後ろの流れは変わりません。
LLM の返事をそのまま話させる
サーバーは LLM で返事を作り、その文章を POST /v1/sessions/:id/speak に渡します。下の llm.reply は、お使いの LLM の SDK に置き換えてください。
サーバー (/api/reply)
export async function POST(req: Request) {
  const { sessionId, userText } = await req.json();
  // そのセッションがログイン中の利用者のものかを、ここで確かめる
  const reply = await llm.reply(userText);

  await fetch(`https://api.avacast.jp/v1/sessions/${sessionId}/speak`, {
    method: 'POST',
    headers: {
      Authorization: `Bearer ${process.env.AVACAST_API_KEY}`,
      'Content-Type': 'application/json',
    },
    body: JSON.stringify({ text: reply }),
  });
  return Response.json({ reply });
}- 1 回に渡せる文章は 1,000 文字までです。
- 前の返事を話し終わるのを待たずに
speakを呼べます。順番に話します (1 セッションあたり 20 件まで)。 - ブラウザが接続する前に呼ぶと
409 session_not_connectedになります。映像が届いた合図は SDK のsession.readyです。
レベルに合わせた話し方
言い回しの難しさや、間違いを指摘するかどうかは、LLM への指示で変えられます。avacast 側の設定は変えずに済みます。
LLM への指示の例
const system = [
  'You are a friendly English conversation partner for a Japanese learner (CEFR A2).',
  'Use short sentences and common words. Ask one question at a time.',
  'If the learner makes a grammar mistake, say the correct sentence once, then continue.',
  'Keep each reply to one or two sentences.',
].join('\n');
返事を 1〜2 文に収めるよう指示しておくと、話し終わるまでの待ち時間が短くなり、会話のテンポが保てます。
料金の目安
課金はセッションを開いていた時間 (接続時間) です。無料プランは月 30 分まで、1 セッション最長 5 分です。1 回 15 分の練習を想定するなら、1 セッション最長 15 分の Starter (¥1,980/月・月 200 分込み) から使えます。
月 30 分まで無料
カード登録なしで始められます。